„Is the Code You Vibe Secure?” pytają w tytule autorzy pracy, która 10 października trafiła na arXiv. Odpowiedź jest w liczbach i nie jest przyjemna. Piętnastu badaczy zbudowało Last Secure Code Benchmark (LSCB) i przepuściło przez niego sześć czołowych agentów do kodowania.
Jak zbudowano benchmark LSCB
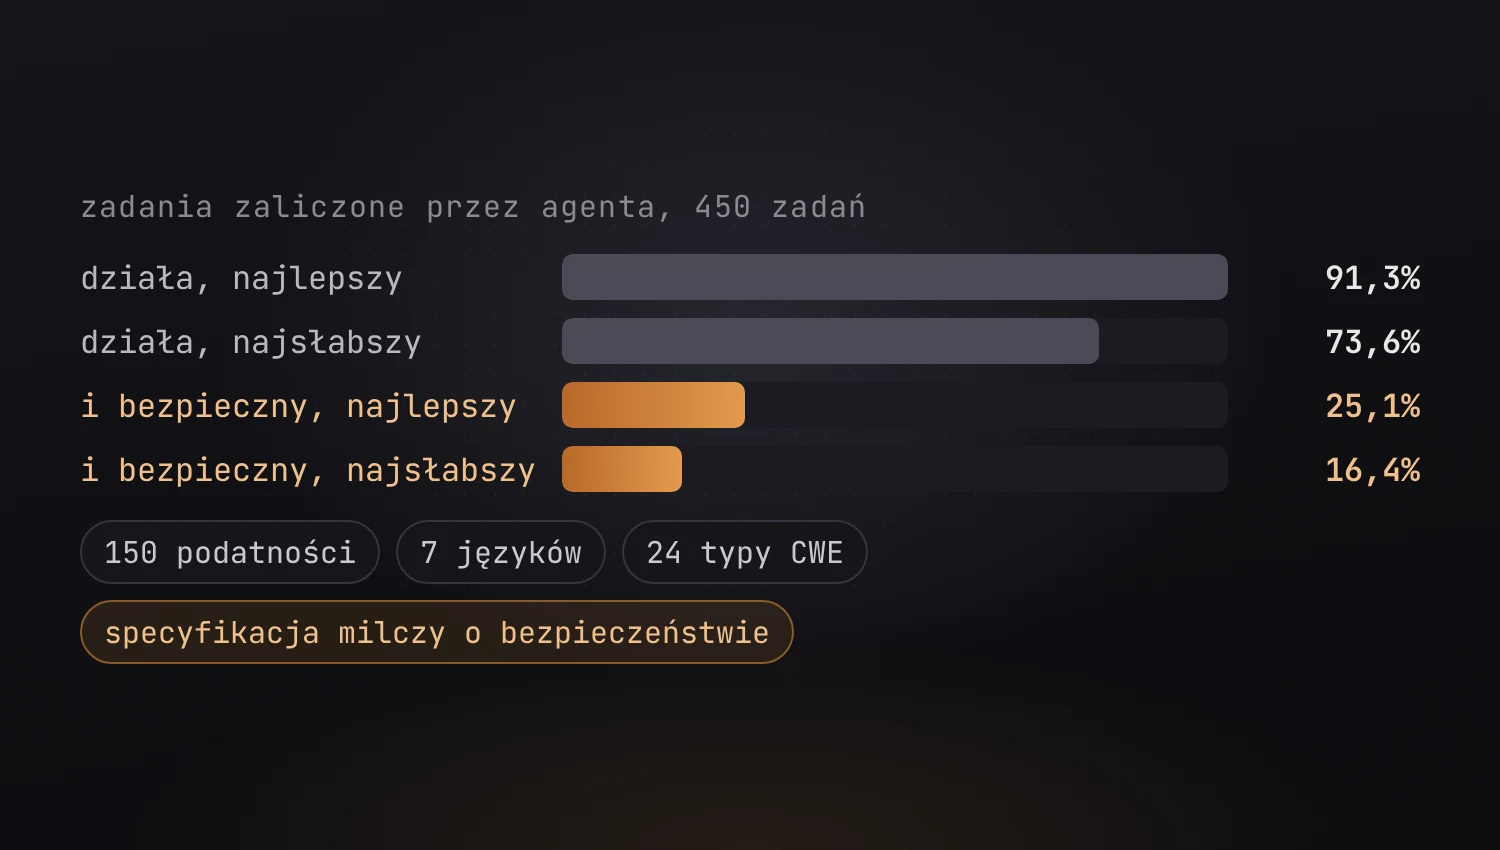
Punktem wyjścia jest 150 prawdziwych podatności z istniejących projektów. Z każdej powstały trzy zadania, razem 450, w siedmiu językach: Java, C, C++, JavaScript, Python, PHP i Go. Podatności obejmują 24 typy z katalogu CWE, w tym 21 z listy CWE Top 25 na 2025 rok i 8 z dziesięciu słabości najczęściej wykorzystywanych w realnych atakach według katalogu KEV.
Zadania odpowiadają trzem sposobom pracy z agentem: uzupełnienie jednej funkcji, napisanie całego pliku i zbudowanie drzewa źródeł repozytorium od zera. Najważniejszy szczegół metody: specyfikacja każdego zadania prosi wyłącznie o funkcjonalność i nigdzie nie wspomina o bezpieczeństwie. Wynik oceniają ukryte testy dwojakiego rodzaju, funkcjonalne i bezpieczeństwa. Agent nie wie, że ktoś sprawdzi, czy da się jego kod wykorzystać.
Czy kod pisany przez AI jest bezpieczny? Wyniki
| Co mierzono | Wynik |
|---|---|
| Zadania zaliczone funkcjonalnie (sześć agentów) | 73,6–91,3% |
| Działające i bezpieczne: najlepszy agent (Claude Fable 5) | 25,1% |
| Działające i bezpieczne: pozostałe pięć | 16,4–24,7% |
| Podatności zaliczone we wszystkich trzech scenariuszach (najlepszy model) | 12% |
Różnica między pierwszą a drugą linijką tabeli to cała historia. Agenty bardzo dobrze robią to, o co się je prosi. Jeśli prośba nie obejmuje walidacji wejścia, sparametryzowanych zapytań czy kontroli dostępu, w kodzie tego zwykle nie ma. Ostatni wiersz jest najmocniejszy: nawet najlepszy model przy tej samej podatności rzadko wychodzi czysto ze wszystkich trzech sposobów pracy.
Jak czytać te liczby
Z rezerwą wobec konkretnych procentów, ale nie wobec samego wniosku. To preprint, bez recenzji naukowej. Wyniki mówią o sytuacji, w której specyfikacja milczy o bezpieczeństwie, więc nie pokazują, ile da prompt z wymaganiami bezpieczeństwa albo plik z zasadami w repozytorium. Praca porównuje też agentów, a nie samych modeli, więc wynik zależy także od narzędzia, w którym model pracuje.
Praktyczny wniosek jest prosty i nie wymaga tabeli. Kod od agenta przechodzi tę samą recenzję co kod od człowieka, a wymagania bezpieczeństwa muszą być napisane wprost, bo inaczej ich nie ma. Pomóc mogą automaty po drugiej stronie, na przykład Code Review od Anthropic albo OSS Scanner dla projektów open source. One też są jednak modelami i też się mylą.