Claude Opus 5.5 wyszedł 22 września 2026. W API nazywa się claude-opus-5-5 i jest dostępny wszędzie tam, gdzie poprzednik: w API Anthropic, na AWS, w Google Cloud i na Microsoft Azure, a także w Claude Code. Po miesiącu da się już powiedzieć, co się zmieniło, i oddzielić twarde liczby od marketingu.
Ile kosztuje Claude Opus 5.5?
| Za milion tokenów | Opus 5.5 | Opus 5 |
|---|---|---|
| Wejście | 4 USD | 5 USD |
| Wyjście | 20 USD | 25 USD |
| Odczyt z cache | 0,20 USD | 0,50 USD |
| Zapis do cache | 5 USD | 6,25 USD |
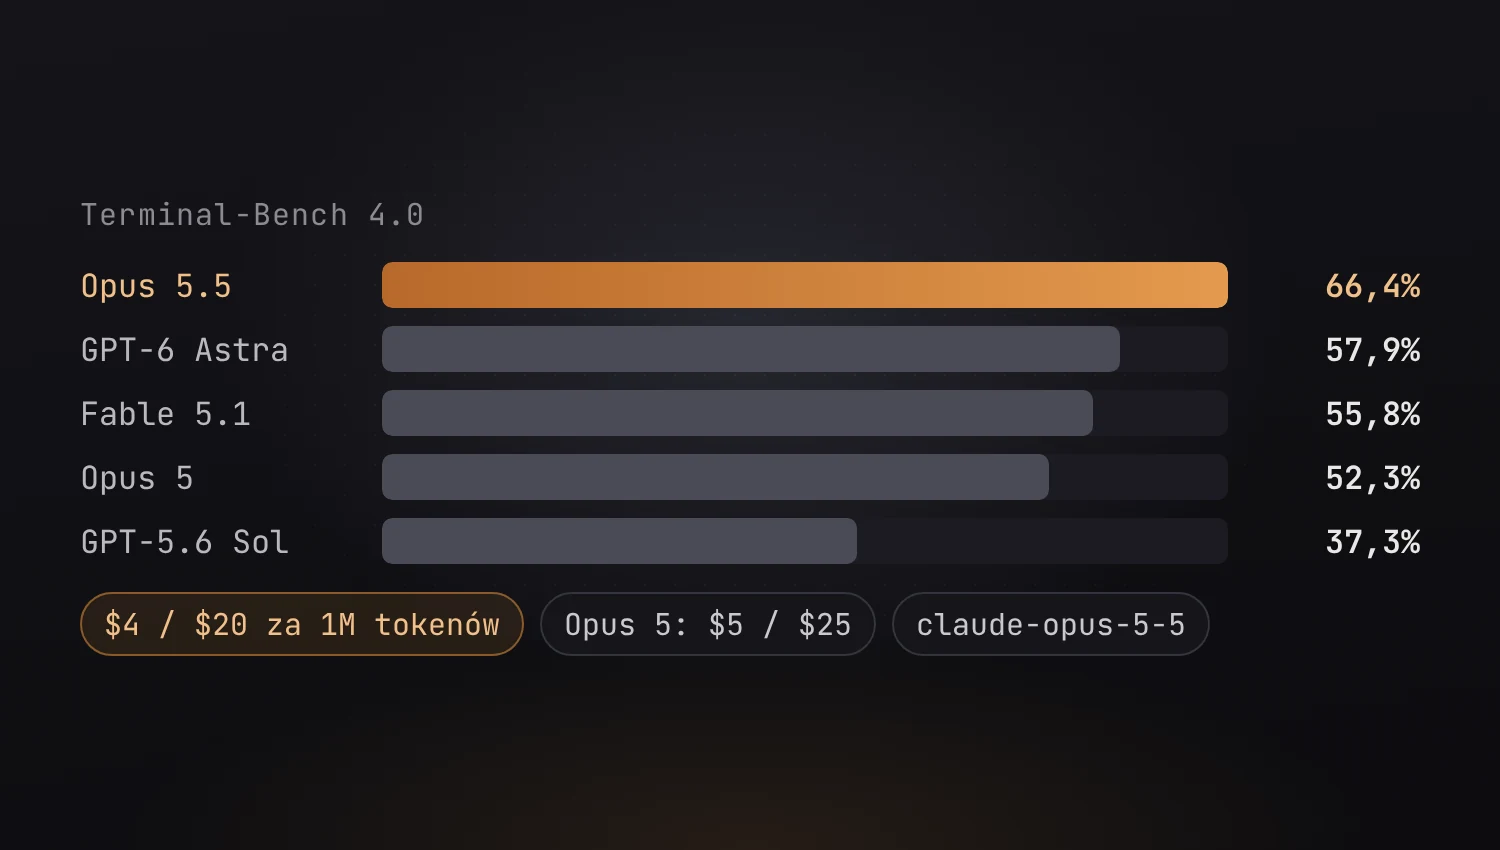
Wejście i wyjście tanieją o 20%, odczyt z pamięci podręcznej o 60%. Do tego dochodzi tryb fast: do 2,5 raza szybciej, za 8 dolarów na wejściu i 40 na wyjściu. Anthropic twierdzi, że przy domyślnych ustawieniach typowe zadanie kosztuje około 40% mniej niż na Opusie 5, a tekst generuje się ponad 30% szybciej. Model ma pięć poziomów wysiłku: Low, Medium (domyślny), High, Xhigh i Max.
Benchmarki: Opus 5.5 kontra GPT-6 Astra
| Test | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| FrontierCode v1.1 | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| CursorBench 4.0 | 57,8% | 51,8% | 46,6% | – | 41,7% |
| AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
Dwie rzeczy psują ten obrazek, i dobrze o nich wiedzieć. Wyniki Opusa 5.5 są liczone na maksymalnym wysiłku, poza Terminal-Bench 4.0, gdzie Opus pracował na Xhigh, a GPT-6 Astra na High (wynik podany przez OpenAI). Przy domyślnym Medium CursorBench spada z 57,8 do 52,5%. Za to FrontierCode na Medium wychodzi 54,6%, czyli minimalnie lepiej niż na Max. Do tego GPT-6 Astra wygrywa AutomationBench i Terminal-Bench-Science (64,6% wobec 58,7%), więc Opus nie bierze wszystkiego.
Czy Opus 5.5 naprawdę jest tańszy na zadanie?
Cena za token to jedno, a liczba tokenów na zadanie to drugie, i tu Anthropic gra najmocniej. Według producenta w FrontierCode Opus 5.5 wygrywa z GPT-6 Astra za około jedną piątą kosztu zadania, a w CursorBench wyprzedza GPT-5.6 Sol o 11 punktów za mniej więcej jedną trzecią. Jest też test z życia: przepisanie HAProxy z C na Rust zajęło 9,5 godziny zamiast 12 na Fable 5.1, przy koszcie niższym o 51%.
Klienci cytowani przez Anthropic mówią podobnie. Box pisze, że odpowiedzi były „40% less verbose without losing accuracy”, a ktoś z Clio, że komentarze w kodzie wyszły „short and useful instead of long and prose-heavy”. To akurat da się sprawdzić u siebie bez benchmarków. Wystarczy porównać diff z tego samego zadania na dwóch modelach.
Dla kogoś, kto siedzi w agent teams albo puszcza długie sesje w Claude Code, obniżka liczy się bardziej niż kilka punktów w tabeli, bo koszt rośnie razem z liczbą agentów. A że Claude potrafi dziś odpowiadać nawet na AmigaOS 3.x, to model wybiera się już nie tylko po wynikach, ale i po tym, ile kosztuje każde jego wywołanie.